Grok API 默认水印上线:xAI 的 EU AI Act 合规与开发者应对指南(2026)
2026 年 11 月 7 日起,xAI 对 7 个 Grok API 模型默认启用不可见文本水印,覆盖普通响应、结构化输出与工具调用参数。本文解析 x-watermark 响应头、按模型退出的治理流程、EU AI Act 第 50 条时限,以及开发者应做的四项准备。
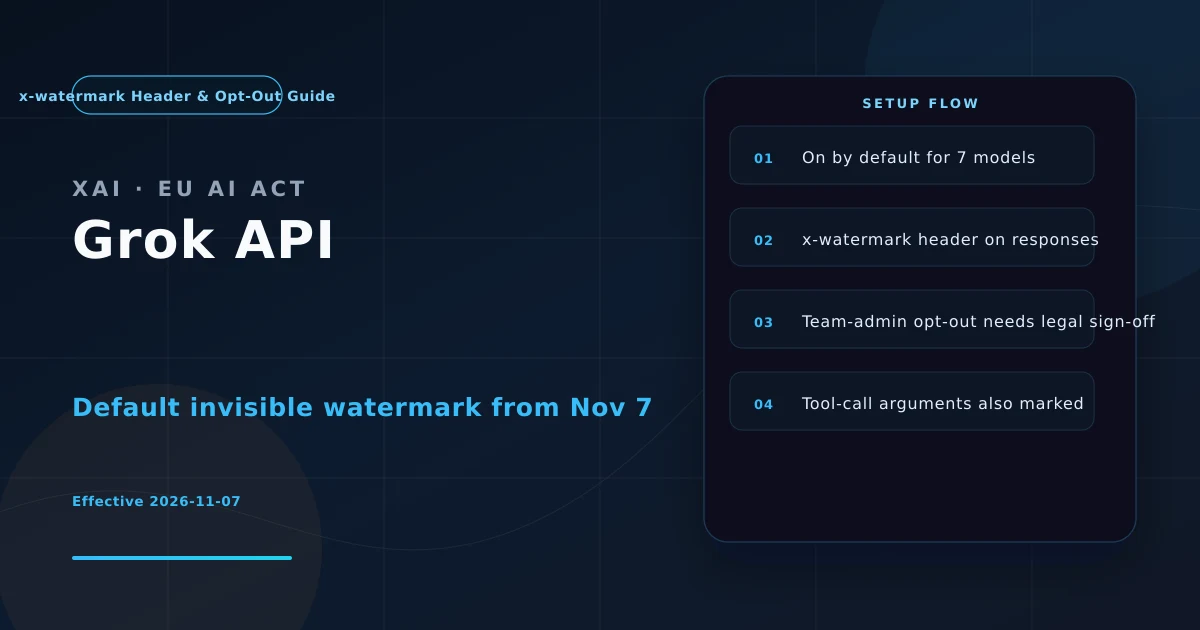
引言:一个不报错、却已经改变你输出的变更
2026 年 10 月 31 日,xAI 在 X 上宣布一项变更,11 月 7 日生效:
从今天起,Grok API 的文本输出将默认携带不可见水印。
这条变更的特殊之处在于——你的代码不会报错。请求照常成功,HTTP 200,响应体照常解析。唯一的变化是响应头里多了一个 x-watermark: true,以及文本本身在采样阶段被轻微塑形。
这正是它值得写一篇技术文章的原因。不报错的破坏性变更最危险:没有异常、没有告警、没有降级信号,只有当你某天去对比”同样的 prompt,2.5 和 2.6 的输出习惯为什么不一样”时才会发现。
本文按官方文档(xAI Developer Docs 的 Output Watermarking 页面,10 月 31 日更新)拆解四件事:
- 到底哪些模型、哪些输出会被标记;
x-watermark响应头怎么用;- 退出流程的治理含义(不是”点个开关”那么简单);
- 开发者现在该做的四项准备。
一、变更范围:比”文本输出”更广
这是第一个容易被低估的细节。
1.1 覆盖的模型(7 个)
| 模型 | 类型 |
|---|---|
grok-4.7 | 通用 |
grok-4.6 | 通用 |
grok-4.5 | 通用 |
grok-4.3 | 通用 |
grok-4.20-reasoning | 推理 |
grok-4.20-non-reasoning | 非推理 |
grok-4.20-multi-agent | 多智能体 |
部分模型可能被锁定,无法关闭水印。xAI 文档没有公开锁定清单,所以别假设所有模型都能退出——请在控制台逐个确认你实际使用的那些。
1.2 覆盖的输出类型(3 类)
这是关键。官方文档明确列出被标记的范围不只是聊天回复:
- 普通文本响应——你直接看到的答案;
- 结构化输出(structured outputs)——JSON 模式、schema 约束的返回;
- 工具调用参数(tool call arguments)——模型生成的函数入参。
第 3 点值得展开。如果你的 Agent 架构是”LLM 决定调用哪个工具、填什么参数”,那么:
- 工具调用参数也会被标记;
- 意味着下游系统拿到的
arguments(比如一条 SQL、一段 shell 命令、一个 URL)都带着统计特征; - 如果这些参数被直接落库、写入日志、或拼接进其他文本,水印信号会扩散到你没预期的数据流里。
这是个真实的合规边界问题:你的系统里哪些字段属于”AI 生成内容”? 现在需要能回答出来。
1.3 覆盖的端点
- 全球端点
api.x.ai; - 区域端点;
- Responses API 和 Chat Completions API 两条协议路径。
二、水印是怎么工作的
官方原话(Output Watermarking 文档):
“It is applied while the model generates text: it slightly shapes which tokens the model picks, so it adds no characters, markup, or hidden text to the response.”
拆开就是三个要点:
| 特性 | 含义 | 对你的影响 |
|---|---|---|
| 采样期塑形 | 不是事后加标签,而是在生成时就轻微偏移 token 采样 | 文本可读性不变,但措辞分布会带统计特征 |
| 零可见改动 | 不加字符、不加标记、不加隐藏文本 | 不需要过滤、不需要清洗;copy-paste 也带水印 |
| 不影响质量与速度 | xAI 明确声明响应质量与生成速度不变 | 性能无回归 |
为什么不加隐藏字符? 因为字符级水印(比如零宽字符)太脆弱——复制粘贴、编码转换、翻译都会破坏。统计水印(statistical watermark)改的是 token 概率分布,复制粘贴不会去掉,深度改写才会削弱。这也是为什么 xAI 的检测 API 返回的是概率性结论。
2.1 检测结果是概率性的
这一点必须讲清楚,否则会有人拿它当”确定判定”用。
xAI 提供单独的检测 API(按 application 申请),返回三种可能:
watermarkednot watermarkeduncertain
第三种是真实存在的状态。含义是:“这段文本太短或信号太弱,无法判断”。媒体常把检测描述成二元的,但官方 API 不是。
长度影响显著:文本越长,统计信号越强,检测越可靠。短句、单个句子、JSON 片段——这些是最容易落到
uncertain的。
三、x-watermark 响应头:最容易被丢掉的审计线索
这是本文最实用的一条建议。
x-watermark: true
- 值为
true→ 该响应带水印; - 值为
false(或缺失)→ 不带(通常是该模型被退出了,或该模型不在覆盖范围)。
关键工程建议:把这个头持久化下来。
理由很直接——Latenode 的分析说得最好:如果你在入库、审核或执行工具调用前丢掉了响应头,你可能失去判断”这段 Grok 生成文本当时到底带没带水印”的最简单证据链。
而事后是补不回来的。
3.1 最小可用实现
import json, datetime, uuid

def call_grok(client, **kwargs) -> dict:
    resp = client.chat.completions.create(**kwargs)

    # 关键:把水印头和响应一起记录,不要只留 content
    audit = {
        "ts": datetime.datetime.now(datetime.timezone.utc).isoformat(),
        "request_id": str(uuid.uuid4()),
        "model": kwargs["model"],
        "watermarked": resp.headers.get("x-watermark"),   # "true" / None / "false"
        "content_sha256": hashlib.sha256(
            resp.choices[0].message.content.encode()
        ).hexdigest(),
    }
    with open("audit/grok_watermark.jsonl", "a") as f:
        f.write(json.dumps(audit) + "\n")

    return resp
三个设计要点:
- 存头,不只存内容——
x-watermark是唯一能证明”当时带没带”的直接证据; - 用指纹而非原文——如果你的日志系统有合规要求,存 SHA-256 指纹既能验证一致性,又不复制敏感内容;
- 绑定 request_id——出事时能回溯到具体哪次调用、哪个 prompt 模板。
3.2 中间件版本(生产环境推荐)
如果你有多个模型供应商,别把这段逻辑散落在业务代码里:
WATERMARK_HEADERS = {
    "grok": "x-watermark",
    # 未来其他供应商可能用别的头名
}

class ProvenanceMiddleware:
    def __init__(self, log_path="audit/provenance.jsonl"):
        self.log_path = log_path

    def wrap(self, provider: str, resp, model: str, request_id: str):
        header = WATERMARK_HEADERS.get(provider)
        flag = resp.headers.get(header) if header else None
        self._append({
            "ts": datetime.datetime.now(datetime.timezone.utc).isoformat(),
            "provider": provider,
            "model": model,
            "request_id": request_id,
            "watermark_header": header,
            "watermarked": flag,
        })
        return resp
一个网关层的价值就在这里:它是唯一能保证”所有供应商的水印头都被统一采集”的位置。散落在各业务模块的实现,三个月后必然有遗漏。
四、退出流程:这不是一个技术开关
第二个容易被低估的细节。
4.1 谁能退出
只有团队管理员(team admin)能退出。持有单个 API key 的开发者没有权限关闭。
这是一个刻意的设计:退出是治理决策,不是技术参数。
4.2 退出需要做什么
- 在 SpaceXSI Console(xAI 开发者平台,现以 SpaceXSI 名义运营)按模型逐个关闭;
- 确认法律豁免适用——控制台要求你勾选”本人确认存在适用的法律例外”;
- 承担相应责任——包括标识义务和披露义务;
- 所有变更被记录(audit log);
- 约 5 分钟内生效,且对全团队所有 API key 统一生效。
4.3 团队级联效应
注意第 5 点:这是团队范围的设置,不随 API key 走。
意味着:
- 你新建一个 API key,继承团队的退出状态;
- 团队里另一个人退出,你也会受影响;
- 如果你的多租户 SaaS 用同一个 xAI 团队,所有租户共享一个水印开关。
对于多租户场景,这几乎必然要求你为不同合规诉求的租户分开建团队——因为退出是团队级粒度,没有更细的粒度可用。
4.4 一个真实的策略张力
2026 年 8 月,xAI 没有加入欧盟关于标记 AI 内容的自愿行为准则(voluntary code of practice)。11 月这次默认开启水印,是一个明显的立场反转——因为法规时限到了。
欧盟 AI Act 第 50 条的义务,加上 AI Omnibus 修订后的安排:
- 2026 年 8 月 2 日之后投放市场的生成式 AI 系统:标记义务立即适用;
- 2026 年 8 月 2 日之前投放的既有系统(pre-existing systems):宽限期到 2026 年 12 月 2 日。
xAI 选在 11 月 7 日默认开启,正好落在既有系统宽限期结束前约三周。
违规罚款最高可达 1500 万欧元或全球年营业额的 3%(取高者)。
这解释了”为什么是 11 月 7 日”这个具体日期——它不是技术选型,是合规倒计时。
五、开发者该做的四件事
按优先级:
1. 立刻盘点:你用了哪些 Grok 模型
在控制台逐个确认你的模型是否在覆盖列表里。特别是:你用的是 grok-4.20-* 系列(reasoning / non-reasoning / multi-agent)的话,水印范围包括工具调用参数。
2. 采集 x-watermark 头
在网关/中间件层统一做,不要散落在业务代码。落进日志或审计表。
3. 决定是否退出,以及谁来决定
这不是技术选择,是合规选择。判断依据:
| 你的场景 | 建议 |
|---|---|
| 面向欧盟用户、输出可被用户看到 | 保持开启——这是法规要求,退出需要真实法律依据 |
| 内部工具链、输出不外传 | 保持开启通常也无害(不影响质量和速度) |
| 输出会被二次加工成”你自己的原创内容” | 谨慎——退出需要法律依据,且退出记录会被审计 |
| 多租户 SaaS,不同租户合规诉求不同 | 拆分团队——退出是团队级粒度 |
4. 测试你的下游管道
如果你的 pipeline 会对 Grok 输出做后处理(摘要、改写、翻译、拼接模板),水印信号会被稀释。特别是:
- 改写/摘要 → 统计特征被削弱,检测可能落到
uncertain; - 翻译到另一语言 → 信号大幅减弱;
- 拼接到大段模板文本 → 信号被稀释。
这会影响你的合规声明——如果你对外说”我们的内容全部可溯源”,得先确认你的处理流程没有破坏这个承诺。
六、和 NixAPI 的关系:聚合层在这里的价值
这一节必须诚实。
现实:Grok 的水印设置是团队级的,x-watermark 头是响应级的。如果你的请求经由聚合层转发:
- 聚合层能否透传响应头?这决定了你的审计链是否完整;
- 聚合层用哪个团队的 key 调用?决定了水印标记的是聚合层的团队,不是你的组织;
- 退出机制是聚合层管理员能做的,不是你的用户能做的。
所以对需要精细合规控制的团队,Grok 的直连 + 自有团队通常仍是必需的。
那聚合层的价值在哪?在统一:
- 一个采集点:网关层统一保留所有供应商的水印/溯源头(
x-watermark、未来的其他厂商头),不遗漏; - 一张视图:按模型、按团队、按请求看”哪些输出被标记”;
- 一份审计:合规团队要证据时,不用去翻五个供应商的日志系统。
NixAPI 统一端点 在这里的定位是可观测性层,而不是”帮你绕过合规”——这两者的区别很重要。
七、结语
这次变更的教训,和 2026-09 那次 OpenAI textGrain 发布其实是同一件事的两面:
OpenAI 的做法:默认开启,但把开关放在 Organization/Project 设置里,给了明确的”如何在组织内做审计”。 xAI 的做法:默认开启,退出需要法律确认 + 承担个人责任,变更全程审计。
两种设计都指向同一个结论——当”AI 生成内容需要可溯源”成为法规要求时,模型供应商正在把”溯源”从模型内部特性,变成一条需要组织级治理**的运营流程。
对开发者的三条实操结论:
- 现在就把
x-watermark采集起来——这是唯一能证明”当时带没带”的证据,事后补不了; - 退出不是技术决策——先问法务有没有真实法律依据,别为了”输出更像人写的”去关;
- 工具调用参数也在范围内——重新审视你的系统里哪些字段属于”AI 生成内容”。
顺带一句:如果你的产品面向欧盟用户,这次变更大概率不是可选项。把它当合规工作做,别当实验做。
延伸阅读:
- xAI 官方:Output Watermarking 文档(10-31 更新)
- xAI 官方:API 文档首页
- 欧盟委员会:AI Act Article 50 透明度义务说明
- 欧盟委员会:AI Omnibus 对既有系统的宽限期安排
- 相关阅读:OpenAI textGrain API 完全指南
本文由 NixAPI 编辑团队撰写。NixAPI 是统一接入多家大模型 API 的聚合服务,支持 OpenAI / Anthropic / Google / DeepSeek / xAI 等 30+ 模型,控制台 注册即送 $1 试用额度。